營運與維護 · 實作指南
PDF 看起來沒問題,AI 接下來讀哪一句?
對照 PDF 原頁與實際擷取文字,檢查雙欄、標籤及先修條件的閱讀順序。
AAHouse 原創解說影片,採用 AI 輔助概念畫面、合成旁白及原創音樂。
英文逐字稿 · 簡體中文普通話逐字稿 · 台灣華語逐字稿 · 澳門粵語逐字稿
先看一頁,再讀一遍
設想一家美國培訓公司把雙欄課程説明交給 AI 起草客服答覆。左欄解釋入門課,右欄介紹進階課。字都提取到了,卻把右欄的先修條件接到左欄後面。這個虛構編輯場景提醒我們:頁面看起來正確,不代表機器收到的句子順序正確。
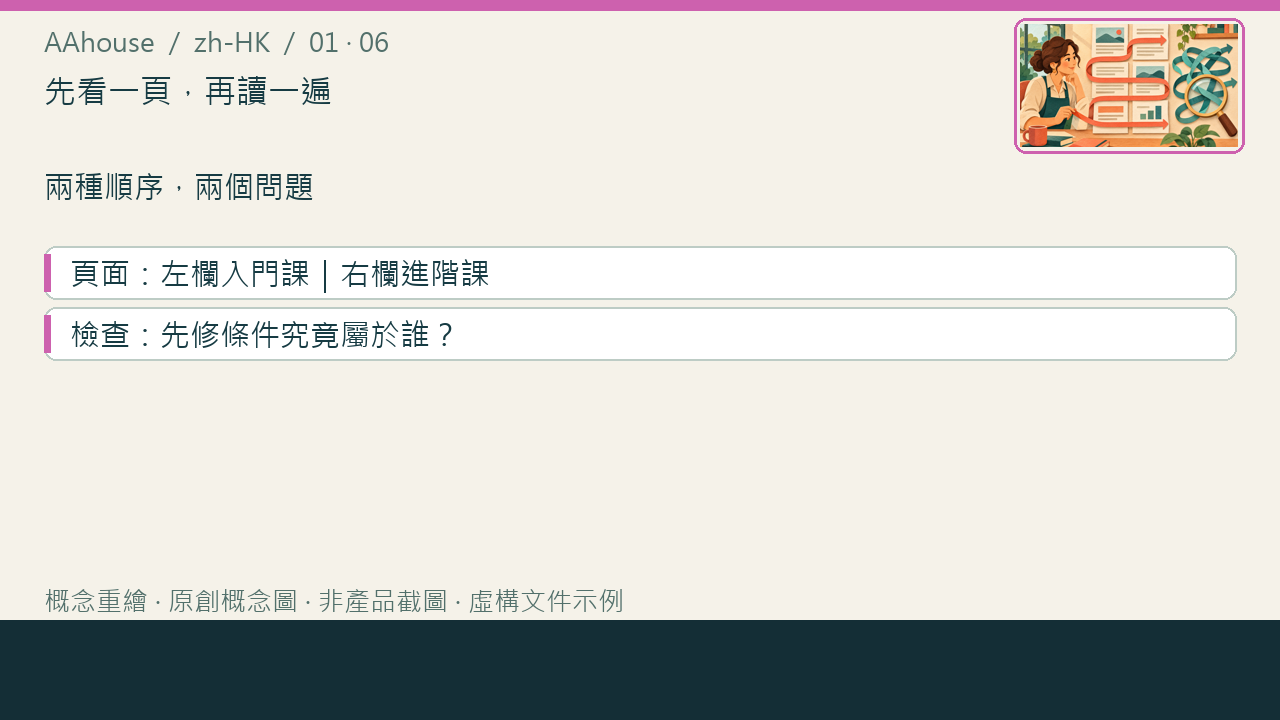
- 頁面:左欄入門課|右欄進階課
- 檢查:先修條件究竟屬於誰?
已接受的區域說明圖重繪,並非未經修改的原始截圖。
把順序畫出來
先在原頁上標出標題、左欄段落、右欄段落和腳註的閲讀路徑,再對照實際送入模型的文字。別隻檢查有沒有漏字;問每個條件究竟修飾哪個課程。把錯接的位置圈出來,比要求模型“認真閲讀”更容易定位問題。這是一項建議的驗收方法,不是已完成的客戶測試。
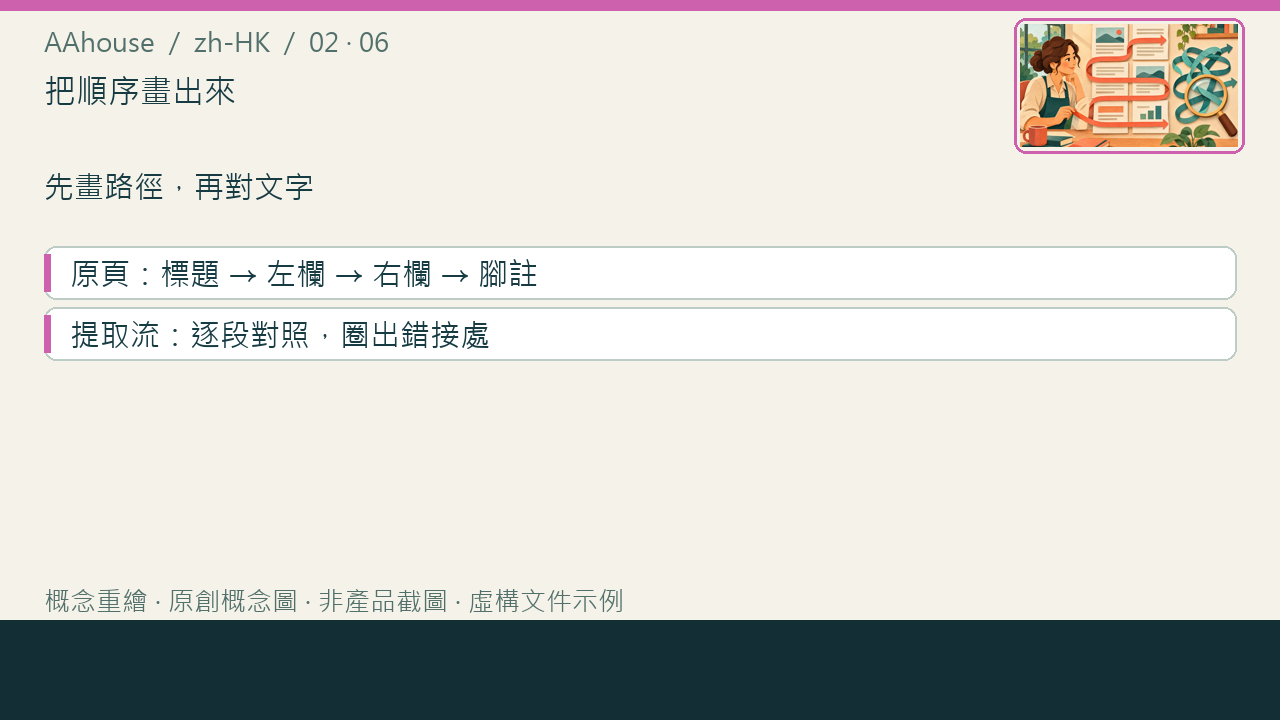
- 原頁:標題 → 左欄 → 右欄 → 腳註
- 提取流:逐段對照,圈出錯接處
已接受的區域說明圖重繪,並非未經修改的原始截圖。
有標籤,也要檢查
W3C 的 PDF3 技術説明指出,帶標籤 PDF 的閲讀順序主要由元素的標籤順序決定;複雜佈局轉換後仍可能需要修正。[1] 這是一份無障礙技術指南,不是某款 AI 的準確率保證。文件標着“已加標籤”,不能替代實際順序核對。
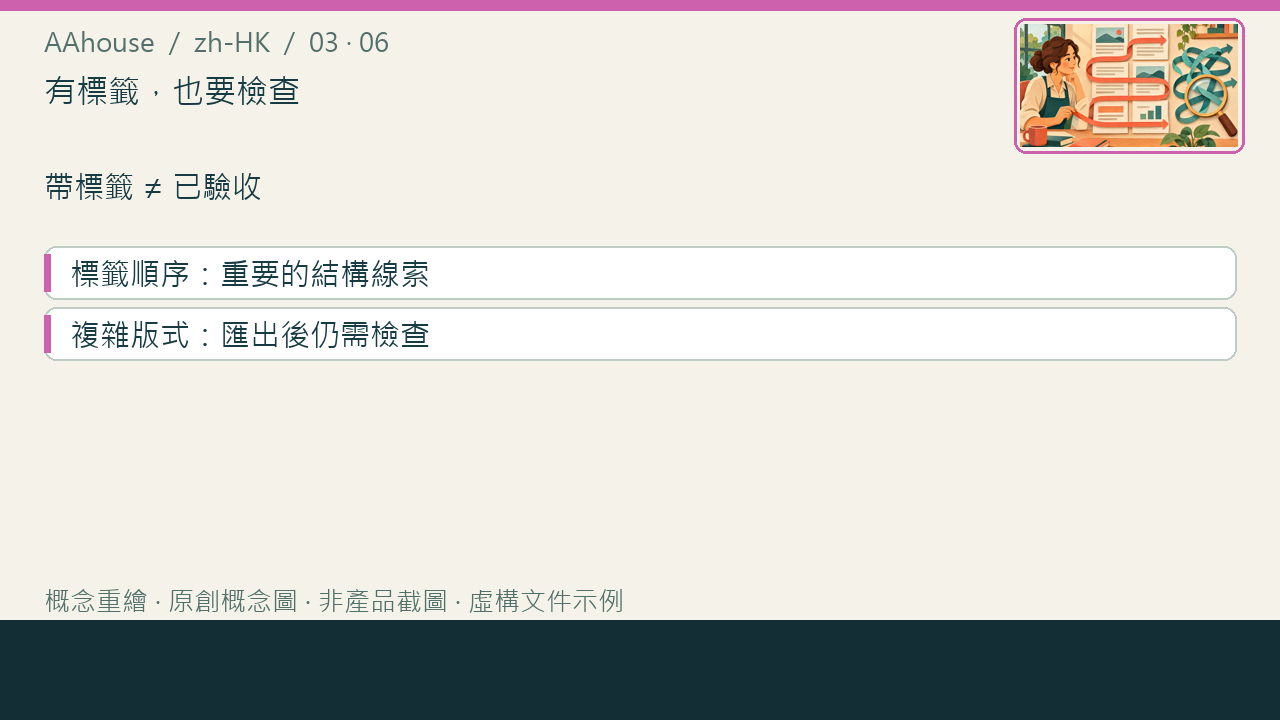
- 標籤順序:重要的結構線索
- 複雜版式:匯出後仍需檢查
已接受的區域說明圖重繪,並非未經修改的原始截圖。
別把排序開關當理解
PyMuPDF 文件提醒,預設提取的文字可能不符合通常閲讀順序,並提供帶位置資訊的文字塊等處理方式。[2] 業務驗收還應關注跨欄、側欄與例外條款。某個排序選項改善一頁,並不證明它理解所有版式。需要對你正在使用的提取路徑做樣本檢查。
- 文字塊與位置:幫助恢復順序
- 跨欄與例外:仍需樣本驗收
已接受的區域說明圖重繪,並非未經修改的原始截圖。
交給同事一份對照單
對這份虛構課程説明,保留三欄記錄:原頁區域、提取後文字、審核者確認的歸屬。要求 AI 答覆引用課程名和對應頁碼;引用存在後,仍要檢查它是否支持答案。若先修條件歸屬不清,先停在待核實,而不是讓流暢的答覆替編輯決定。
- 原頁區域|提取文字|確認歸屬
- 歸屬不明 → 待核實,不猜測
已接受的區域說明圖重繪,並非未經修改的原始截圖。
先修源文件,再擴樣本
若同一版式反覆錯接,優先簡化源文件結構,保留明確標題與邏輯順序,再重新匯出和檢查。隨後加入跨頁段落、腳註及雙欄樣本。把“文字齊全”和“順序正確”分開驗收。改善源文件既方便同事閲讀,也能減少後續整理工作;實際收益仍需試點衡量。
- 檢查一:文字是否齊全?
- 檢查二:邏輯順序是否正確?
已接受的區域說明圖重繪,並非未經修改的原始截圖。