营运与维护 · 实作指南
AI 评论摘要,不是一份顾客调查
区分公开评论的来源范围、主题分类与代表性,避免把摘要当成全体顾客调查。
AAHouse 原创解说视频,采用 AI 辅助概念画面、合成旁白及原创音乐。
英文逐字稿 · 简体中文普通话逐字稿 · 台湾华语逐字稿 · 澳门粤语逐字稿
老板问:大家都在抱怨吗?
设想一家美国自行车维修店,让 AI 汇总公开评论。摘要说“顾客最在意等待时间”,老板便想增加排班。先别把这句话当成调查结论:写评论的人、被平台展示的评论、实际交给模型的评论,可能是三组不同的范围。这是虚构决策场景,不是客户案例。
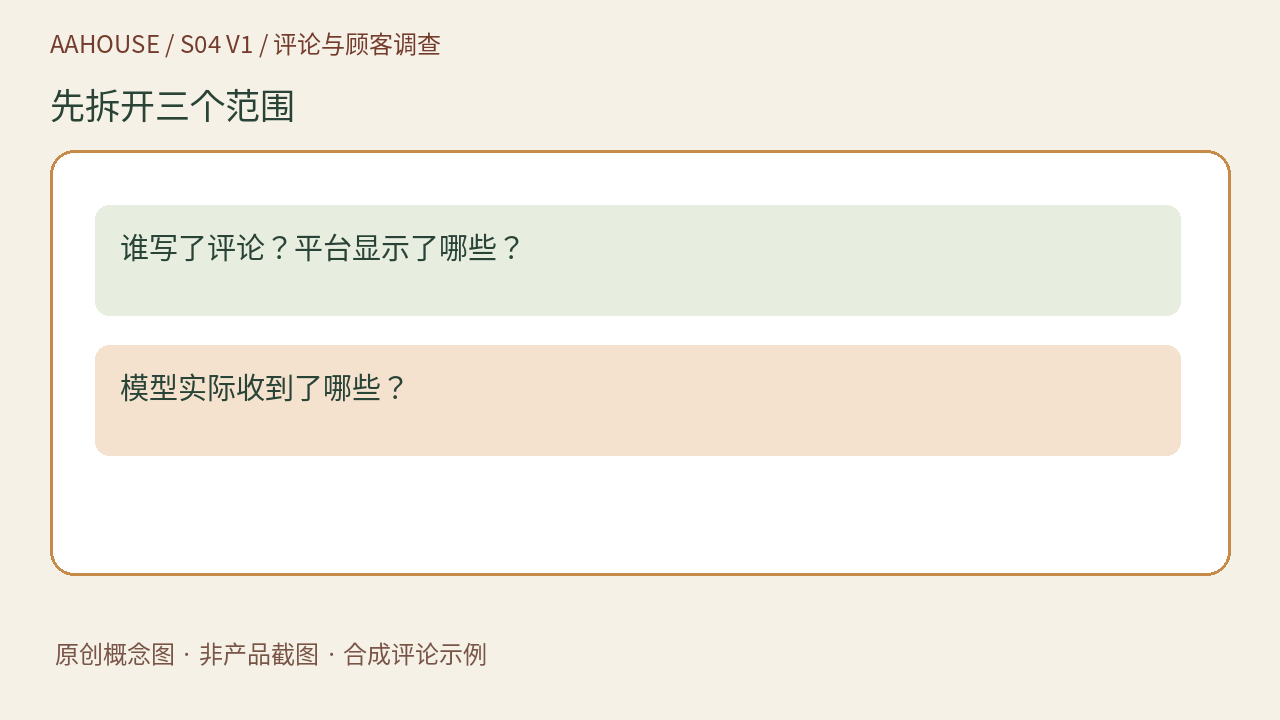
- 谁写了评论?平台显示了哪些?
- 模型实际收到了哪些?
未经修改的原始来源说明图。
分析员答:先说清楚“谁”
把问题改成“本次收集的评论里,哪些内容提到等待?”同时记录平台、日期区间、筛选条件与评论条数。AAPOR 的调查最佳实践强调,样本设计影响结论能够推广到谁。[1] 公开评论可以提供线索,却不能仅因数量多,就自动代表所有顾客。
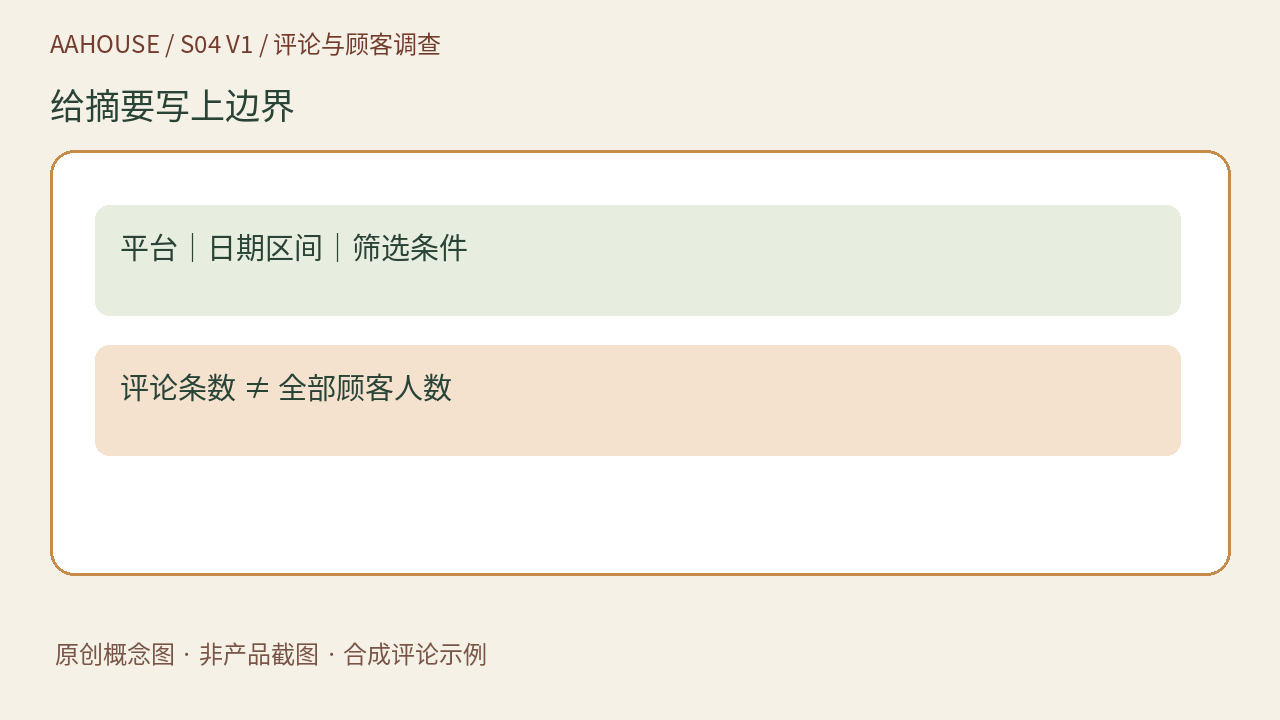
- 平台|日期区间|筛选条件
- 评论条数 ≠ 全部顾客人数
未经修改的原始来源说明图。
编辑追问:模型看到了哪些?
保存经授权取得的评论原文与来源,给每条分配内部编号。要求摘要里的每个主题附上支持编号,并抽查正面、负面和含糊表达。不要把“等得值得”算成抱怨,也不要把同一人重复描述的一次经历,当成多位顾客的独立意见。
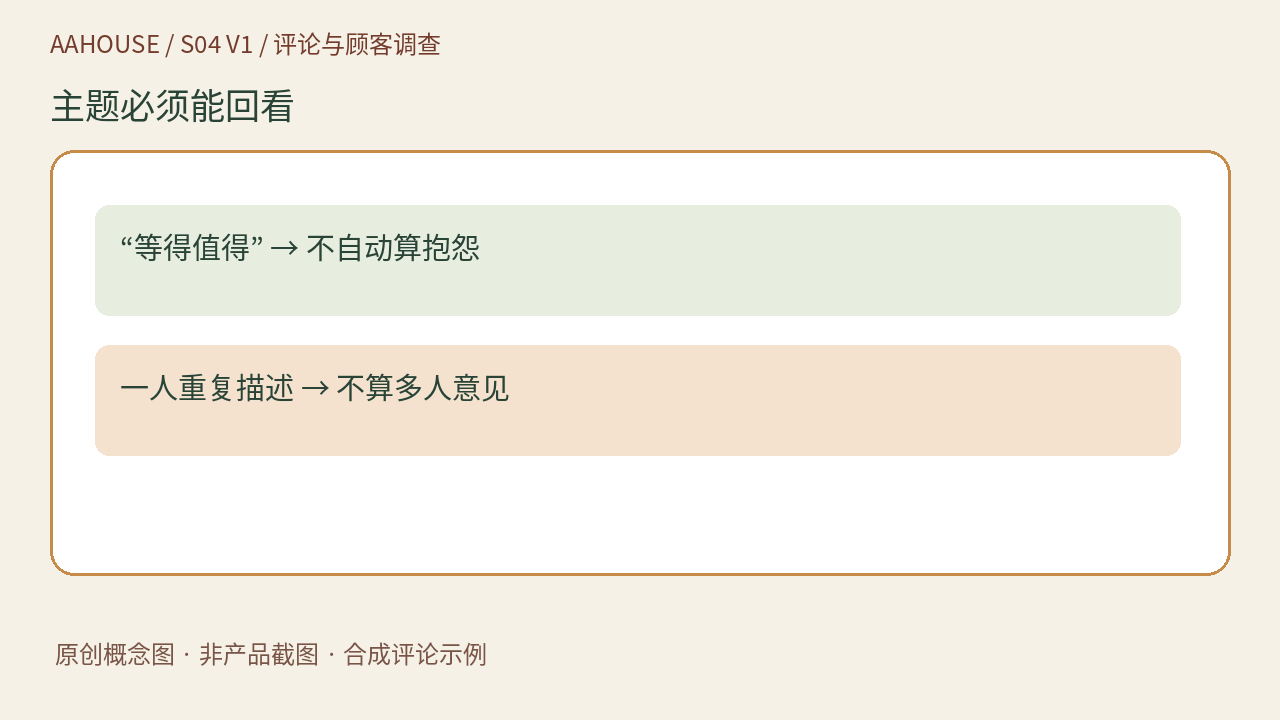
- “等得值得” → 不自动算抱怨
- 一人重复描述 → 不算多人意见
未经修改的原始来源说明图。
店长再问:数字该怎样写?
在合成示例中,二十条评论里六条提到等待,只能写“本次二十条评论中有六条提及等待”,不能写“三成顾客不满”。提及不等于不满,评论也不等于顾客。保留分母、时间窗口和分类定义,让同事能够复核,而不是只留下漂亮的比例。
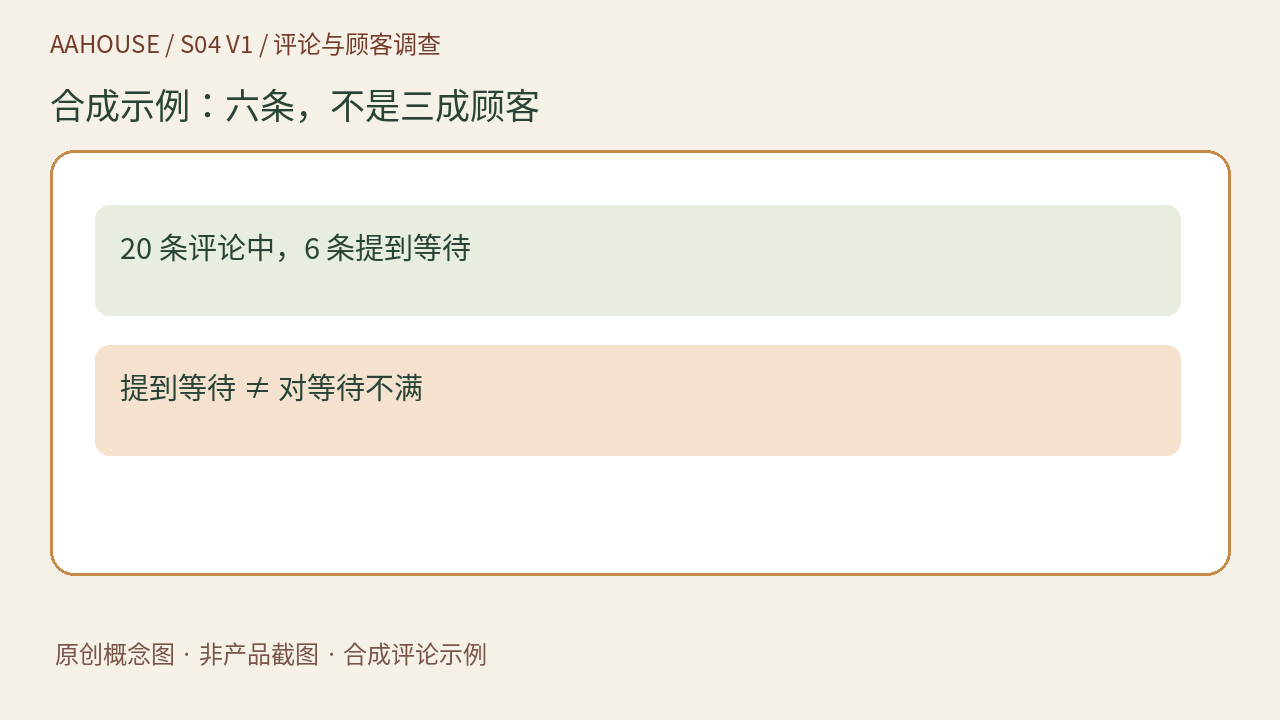
- 20 条评论中,6 条提到等待
- 提到等待 ≠ 对等待不满
未经修改的原始来源说明图。
采购提醒:真实也不等于代表性
FTC 的消费者评论规则于二〇二四年十月二十一日生效,针对包括虚假评论在内的欺骗性做法。[2] 这不意味着平台上的每条评论都已通过核验。真实性与代表性是两道不同的问题;也不要仅凭 AI 的语气判断,就指控某位评论者造假。
- 真实性:这段经历可信吗?
- 代表性:它能说明哪些人?
未经修改的原始来源说明图。
下一次会议只做一个决定
把评论主题当成调查入口:先核对预约到店与完成时间,再邀请不同类型的顾客反馈。若确实发现等待集中在某个时段,就试行小范围排班调整并观察结果。AI 的价值是帮助找到值得追问的问题;是否增加长期成本,应由更完整的业务证据支持。
- 评论线索 → 核对实际等待记录
- 小范围调整 → 观察后再决定
未经修改的原始来源说明图。