
评估与品质 · 观点评论
用 AI 评分 AI,仍需要人工校准
评分模型可以协助分流,但不能因为输出分数便自动代表品质。
先有清晰评分规则
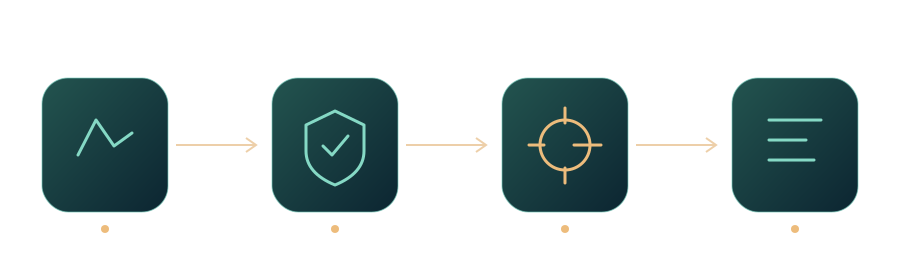
若只问答案好不好,评分模型可能奖励自信文笔,而非政策正确。应分别定义证据支持、必要事实、禁止行为、清晰程度及有效下一步。Bedrock 文件介绍人工与模型评估,但评分规则仍属本地业务决定。先写出合格、边界及不合格例子,再请模型批量评分,才能判断它是否理解公司的标准,而不是只产生漂亮的数字。
用分歧来校准
以假设的知识助手为例,两位审核者先独立评分一组混合例子,再与模型理由比较。人员互相不同意,可能揭露政策含糊,而不一定是模型不好。保留文笔很有说服力却有事实错误的样本。不要只放明显失败,校准集应包含忙碌审核者容易相信、但後果值得注意的情况,也要讨论哪些分歧需要正式业务决定。
流程一览
保护评分过程的输入
待评答案与检索内容应是被评估资料,不是给评分模型的新指令。答案可能包含要求忽略错误或给高分的文字,因此应把评分规则分开,并用合成内容测试这种干扰。记录评分模型版本与设定,日後分数改变才容易追查。评估亦不代表可以任意提供客户资料,应遵守与正式流程一致的资讯最小化及存取安排。
让分数帮人找到重点
校准後可用模型找出优先审核对象,但仍要定期人工抽查,并覆核所有後果重要的失败类别。报告分歧率与盲点,而不是只给一个醒目的品质分。供应商更新模型後,重新检查校准。最终价值应是更快、更一致的审核流程,不是循环论证:因为另一个助手说好,所以这个助手一定可靠。重大业务决定仍应由负责人验收。
保留盲测校准样本
可行时打乱答案次序并隐藏模型身份,让审核者盲评。比较理由,而不只比较最後分数。若评分模型持续偏好某种写作风格,应修改规则或缩小它的用途,不应直接认定被偏好的系统较准确。校准材料亦应定期更新,以免评分工具只擅长旧题目,却错过新服务或新语言带来的不同失败模式。
来源与延伸阅读
编辑原则
本系列以 AI 辅助原创撰写,并对照连结的公开来源。实作建议与假设情境属编辑分析,并非客户实绩。来源发布日期及产品细节可能与本系列整理日期不同。