
营运与维护 · 实作指南
失败队列需要负责人,也需要重播计划
隔离失败工作只是开始,还要有人诊断并完成处理。
停放失败工作不等於恢复
假设请求系统把重复失败搬到另一条队列,主画面看来恢复正常,客户工作却被遗忘。AWS SQS 文件说明这种失败隔离机制,但隔离不等於处理。建议每个停放项目都当成未完成业务工作,附负责人、处理时间与原因。队列数量有用,最旧受影响请求的年龄可能更急迫。客户介面也应反映需要处理,而不是因搬走错误就显示全部健康。
保留足够而有限的诊断脉络
保存操作参考、安全错误类别、尝试历史和设定版本;敏感内容存取则有限期、有限人员。来源资料错误、连接器故障和权限被撤销应分开,因为下一步不同。支援人员应能判断是改资料、恢复存取、修程式或取消工作,不必先读完整原始对话。若每次诊断都需要工程师猜测,就应改善错误分类,而不是只把重试次数再提高。
流程一览
重播仍要接受现在的检查
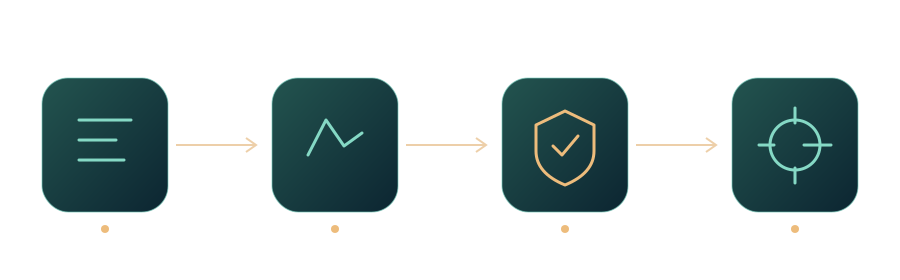
重播前确认工作仍然需要、纪录未有重要变更,以及目前身份仍获授权。沿用操作识别码,防止重播变成另一张新订单。大量重新处理前先试一项。有顺序要求的流程尤其要注意,搬走其中一步可能改变後续含义;不能以为队列重新送出就自动保留业务次序。必要时先核对整段流程,再由负责人决定从哪个安全检查点恢复。
把失败模式变成改善项目
定期按原因和重复程度检视已解决项目。如果常见原因是缺客户编号,就改善接收表单,而不是养成永久人工补救。如果多为提供方故障,就检查重试与替代路径。失败队列本身也需要保留和清理政策。隔离能减少主流程干扰,但没有核对和责任分工,可能只是把未履行的服务藏起来,不是真正提高可靠性。
定期检查解决而非只清空
定期抽查已关闭失败工作,判断它是完成、经同意取消,还是被悄悄丢弃。清空队列不等於解决客户请求。保留精简核对报告,让支援能解释结果,又不必留大量原始内容。若项目没有正式结案状态,就容易把删掉当作完成;应把这两者分开,并让取消需要有理由和负责人。这也是持续服务品质可观察的一部分。
来源与延伸阅读
编辑原则
本系列以 AI 辅助原创撰写,并对照连结的公开来源。实作建议与假设情境属编辑分析,并非客户实绩。来源发布日期及产品细节可能与本系列整理日期不同。