
营运与维护 · 实作指南
监察卡住的客户工作,而不是每次模型例外
增加仪表板之前,先让每个警报对应负责人和处理方法。
有例外不一定需要叫醒人
假设分类器暂时失败後重试成功,途中却发出三个警报;另一项批准等了两天反而无人察觉。建议围绕业务损害设警报,例如最旧未解决请求、连接器反覆失败、非预期外部操作或无人负责恢复。CloudWatch 文件提供警报机制背景,真正门槛与处理责任则来自流程服务期望。技术事件多,不代表重要客户问题也被看见。
先写处理方法,再写警报规则
每个警报先定义第一负责人、安全诊断画面、可立即采取的操作及升级路径。只写模型错误而没有请求参考,通常无法行动。需分清立即控制与下个工作天调查。用合成事件验证送达,警报内容不附客户文件。若通知寄到已无人看的信箱,即使监控平台显示已发送,也不能代表有可用处理路径;人员异动时要一并维护联络名单。
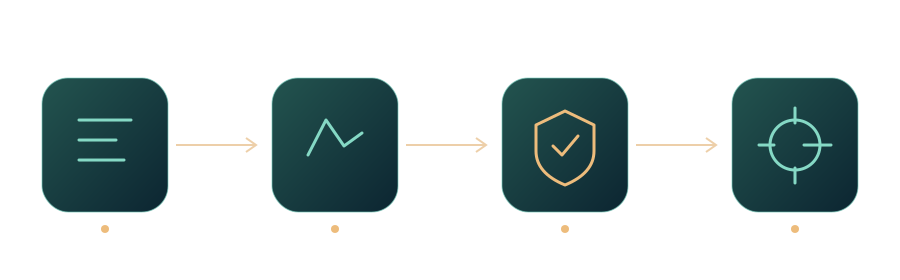
流程一览
以精简维运表取代指标海洋
可先看未解决请求年龄、外部操作确认率、审核积压、失败工作数与恢复时间。把同一故障的症状分组,避免通知淹没人员。门槛异常时先查原因:队列增加可能是提供方变慢、需求增加或缺审核者,不是每种原因都适合自动扩容。维运表要帮助选择下一步,而非只显示大量图表。高度自动化也仍需要业务脉络。
把警报噪音当成成本
试点期间将警报分类为有用操作、重复、误报或缺脉络,记录投入时间与未解决结果。删除或重设噪音规则前,先确认原风险仍有人覆盖。安静仪表板不证明可靠,繁忙仪表板也不证明监控做得好。真正证据是正确的人能否在约定时段发现并解决受影响工作。这也有助为持续支援报价,而不是把每月服务理解成无限通知。
约定真正有人处理的时段
明确约定警报只在办公时间处理,还是有人全天候回应;适用时另设紧急事故路径。系统半夜自动发讯,不代表有人正在监看。清楚的服务时段让托管承诺更可信,也较容易定价。若客户需要更高覆盖,应评估人员与交接成本,而不是把通知频率调高就算完成。这项商业安排与监控技术同样影响真实可靠性。
来源与延伸阅读
- Using Amazon CloudWatch alarmsUsing Amazon CloudWatch alarmsAWS · 官方文件 ·
- TracesTracesOpenTelemetry · 官方文件 ·
编辑原则
本系列以 AI 辅助原创撰写,并对照连结的公开来源。实作建议与假设情境属编辑分析,并非客户实绩。来源发布日期及产品细节可能与本系列整理日期不同。