
公司知識 · 觀點評論
先改善證據選擇,再控制 RAG 成本
上下文長度應跟隨問題需要,而不是把能放的資料全部放入。
先規劃資訊,再規劃 token
更長上下文可能只是掩蓋薄弱檢索,把很多邊緣段落一起送給模型。先確認問題真正需要哪些證據,再分開看檢索數量、片段長度、重新排序與答案生成的成本。上下文檢索研究提供實驗背景,卻沒有為所有企業文件訂出通用最佳長度。計算預算前,也應分辨有價值的證據與重複文字,避免因技術上放得下便全部加入。
量度每個已解決問題的成本
以假設的政策助手為例,在相同問題比較較短與較廣的證據集,記錄檢索成功、無依據主張、延遲、用量與審核投入。便宜答案若需要長時間人工修改,總成本可能更高。長答案附很多引用,亦未必解決員工真正問題。先定義「已解決」,再訂成本目標,並把轉人工、重試及後續查證一起納入,而不只計算一次模型呼叫。
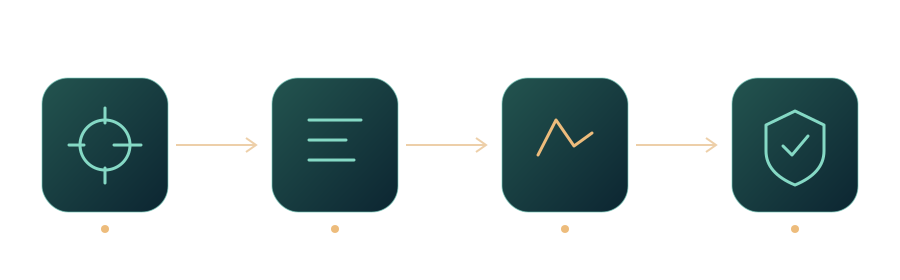
流程一覽
留意重複證據
重疊切片、鏡像資料夾及翻譯副本可能擠掉不同證據。抽查檢索集合,觀察額外段落是提供新資訊,還是只是重複。標籤可靠時可按版本與範圍篩選,但不能為節省 token 壓掉例外條款。提示更短只有在保留正確及授權答案所需資訊時才有價值。成本優化應保留對照測試,否則很容易把品質下降誤認為效率提升。
設定可維護的營運範圍
記錄預期問題量、更新頻率、合理證據上限及大型請求的後備處理。試點後再按實際費用檢討,不要從實驗室結果承諾固定節省。將向量化與匯入成本和日常查詢成本分開,便能解釋為何同樣問題量下,經常更新的資料庫與穩定手冊有不同成本。最終選擇應同時符合品質、回應時間及團隊可持續承擔的維護範圍。
每週抽查證據集
每週抽查少數高成本問題,逐段檢查取回內容。只有確認例外與矛盾證據仍可見,才移除冗餘檢索,並保留前後解決品質紀錄。成本檢討應保護有用證據,而不是只獎勵短答案。若少數查詢需要很長背景,可另外設計較慢的審核路徑,避免為這些特例提高所有日常問題的固定成本。
來源與延伸閱讀
編輯原則
本系列以 AI 輔助原創撰寫,並對照連結的公開來源。實作建議與假設情境屬編輯分析,並非客戶實績。來源發布日期及產品細節可能與本系列整理日期不同。