
營運與維護 · 實作指南
AI 事故簡報應讓營運同事能採取行動
說明受影響工作、可行後備方式與復原核對,而不只是轉寄模型錯誤。
把技術失敗翻譯成工作影響
假設收件服務遇到模型逾時。原始錯誤代碼無法告訴營運團隊,哪些客戶請求尚未處理。第一份簡報應列明流程、時間範圍、已知受影響紀錄,以及是否可能已執行對外動作。不知道的地方要明確標示,不要因為希望快速交代,就讓 AI 補出一個聽起來完整、實際未核實的事故原因。
提供有界線的後備處理
指定誰有權暫停自動化,以及員工應轉到哪個人工隊列。說明哪些工作可繼續,哪些須等核實,並讓忙碌的協調員也能跟得上。AI 建議的應急做法不應繞過正常權限與批准安排;例如服務故障不能成為把整批客戶資料寄到私人郵箱、或改用未批准工具的理由。
流程一覽
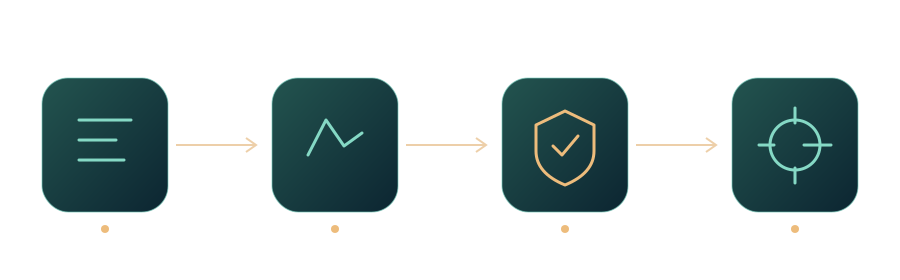
輸入整理審核執行
區分技術恢復與業務對帳
服務指標轉綠,不代表每項請求已正確完成。重跑之前,先把受影響識別碼與來源紀錄及下游結果對帳,查找部分寫入與重複通知。監控文件可以協助收集訊號,但何時業務紀錄已足夠一致、可以恢復,仍要由事故負責人決定。否則一次復原可能把原來的延遲變成更多錯誤。
以具體改善工作結案
結案時寫清已核實影響、復原依據及一項有負責人的預防工作。廣泛通知渠道不要帶上敏感內容。之後追蹤改善是否完成並測試,而不是在事後報告寫完後便結束。事故簡報不是文筆比賽,重點是讓團隊下次更早辨認異常,並知道如何以可控方式繼續工作。
可以立即進行的練習
為模擬事故寫五行:流程、已知影響、未知影響、暫時渠道與下次更新負責人。請同事說出下一步;若只能重複代碼,就改訊息。練習在受控渠道進行,不用客戶內容或外部收件人。真正事故不應一邊猜測一邊廣播;先釐清哪些人需要操作指示、哪些只需狀態更新,並明訂誰可宣告恢復,才能防止每位同事收到不同版本而各自行動。
來源與延伸閱讀
- Monitor bedrock-runtime inference using CloudWatch metricsMonitor bedrock-runtime inference using CloudWatch metricsAmazon Web Services · 官方文件 ·
- Generative AI lifecycle — Generative AI LensGenerative AI lifecycle — Generative AI LensAmazon Web Services · 官方文件 ·
編輯原則
本系列以 AI 輔助原創撰寫,並對照連結的公開來源。實作建議與假設情境屬編輯分析,並非客戶實績。來源發布日期及產品細節可能與本系列整理日期不同。